Fehlersuche in SPS-Programmen: Anlage steht, was jetzt?
Vom Meldefenster zum Baustein: die Reihenfolge, die bei der Störungsanalyse unter Zeitdruck trägt, die TIA-Werkzeuge dazu und fünf typische Fehlerklassen.
Warum Trial-and-Error der teuerste Weg ist
Eine Anlage steht. Die Produktion wartet, das Telefon klingelt, und im TIA Portal starrt einen ein Programm an, das gestern noch lief. Der Reflex in dieser Lage ist fast immer derselbe: irgendwo hineinschauen, wo man den Fehler vermutet.
Genau das ist der teuerste Weg. Nicht, weil Vermutungen grundsätzlich falsch wären – sondern weil eine widerlegte Vermutung nichts hinterlässt. Man weiß danach nicht mehr als vorher und hat zwanzig Minuten verloren. Nach der fünften Vermutung ist eine Stunde weg, und der Druck ist gestiegen.
Systematisches Eingrenzen verhält sich umgekehrt: Jeder Schritt halbiert den Suchraum, unabhängig davon, ob die Annahme stimmte. Auch ein negatives Ergebnis ist ein Ergebnis.
Die Reihenfolge, die unter Zeitdruck trägt
Jede effiziente Fehlersuche folgt derselben Kette:
Symptom → Meldung am HMI → betroffener Baustein → Signalpfad → Ursache
Der erste Blick gehört nicht ins TIA Portal, sondern auf das Bediengerät.
Schritt 1: Das Meldefenster, nicht der Code
Wenn eine Anlage steht, hat sie dazu in der Regel etwas zu sagen. Die Alarmdiagnose am Bediengerät – am WinCC Unified Panel genauso wie am Comfort Panel – zeigt, welche Meldung ansteht, seit wann und in welcher Reihenfolge sie kam. Nichts verkleinert den Suchraum schneller: Die Meldung benennt Aggregat und Funktion, im gepflegten Meldekonzept samt Klartext, warum die Freigabe fehlt.
Entscheidend ist dabei die Reihenfolge der Meldungen, nicht die oberste Zeile. Die zuerst gekommene Meldung ist meist die Ursache, alles danach Folgemeldung – ein Not-Halt reißt eine ganze Kette hinter sich her, und wer die letzte Meldung zuerst untersucht, arbeitet am Symptom.
Der zweite Blick geht ins Meldearchiv. Dort steht nicht nur, welche Störung kam, sondern wie oft und zu welcher Uhrzeit – und damit die Antwort auf die Frage, die über das weitere Vorgehen entscheidet: Einzelfall oder Dauerzustand? Zehn gleiche Meldungen an einem Morgen, jedes Mal quittiert und weitergefahren, beschreiben ein anderes Problem als eine Störung, die zum ersten Mal auftritt – auch wenn der Meldetext identisch ist.
Und wenn nichts ansteht? Dann ist das selbst ein Befund. Entweder gibt es für diesen Fall keine Meldung – dann fehlt sie im Meldekonzept und gehört auf die Nachliste –, oder die Anlage steht gar nicht wegen einer Störung, sondern wegen einer Verriegelung, die genau so gewollt ist: fehlende Freigabe, falsche Betriebsart, ein offener Schutztürkontakt.
Schritt 2: Wenn keine Meldung ansteht – Diagnosepuffer und LEDs
Erst hier wird der Diagnosepuffer der CPU interessant, und dann sehr schnell: Er protokolliert Baugruppenausfälle, Peripheriefehler, STOP-Ursachen und Zeitfehler mit Zeitstempel. Steht dort ein Baugruppenausfall, ist jede weitere Minute im Programmcode verloren.
Für eine Fehlerklasse ist er sogar das Mittel erster Wahl: Kommunikationsprobleme. Ein abgerissener PROFINET-Teilnehmer, ein Wackelkontakt in der Leitung, ein Gerät, das zyklisch kommt und geht – solche Ereignisse landen mit Zeitstempel im Diagnosepuffer, während im Programm nur zu sehen ist, dass Werte einfrieren. Dieselbe Faustregel gilt für Hardware. Umgekehrt gilt: Ein reines Logikproblem findet man dort nicht – dafür ist die Meldung am HMI der Einstieg.
Dasselbe gilt für die LEDs an CPU und Peripherie. Eine rote SF-LED an einer ET 200 beendet die Diskussion über Programmlogik in zwei Sekunden.
Schritt 3: Vom Alarm zum zuständigen Baustein
Die Meldung ist der Einstieg in den Code: Wo wird dieses Meldebit gesetzt? Ein Querverweis auf die Meldevariable führt direkt in den Baustein, der die Störung erzeugt – vorausgesetzt, das Programm ist sauber strukturiert und die Meldungen entstehen an definierter Stelle je Anlagenteil.
Formulieren Sie das Symptom parallel so konkret wie möglich: nicht „die Anlage geht nicht“, sondern „Förderband 3 läuft nach Startbefehl nicht an, Störmeldung ‚Rückmeldung Antrieb fehlt‘ nach 5 Sekunden“. Aus dieser Formulierung folgt der Baustein fast von selbst. Ist alles in OB1 verdrahtet, beginnt hier der mühsame Teil.
Schritt 4: Den Signalpfad rückwärts verfolgen
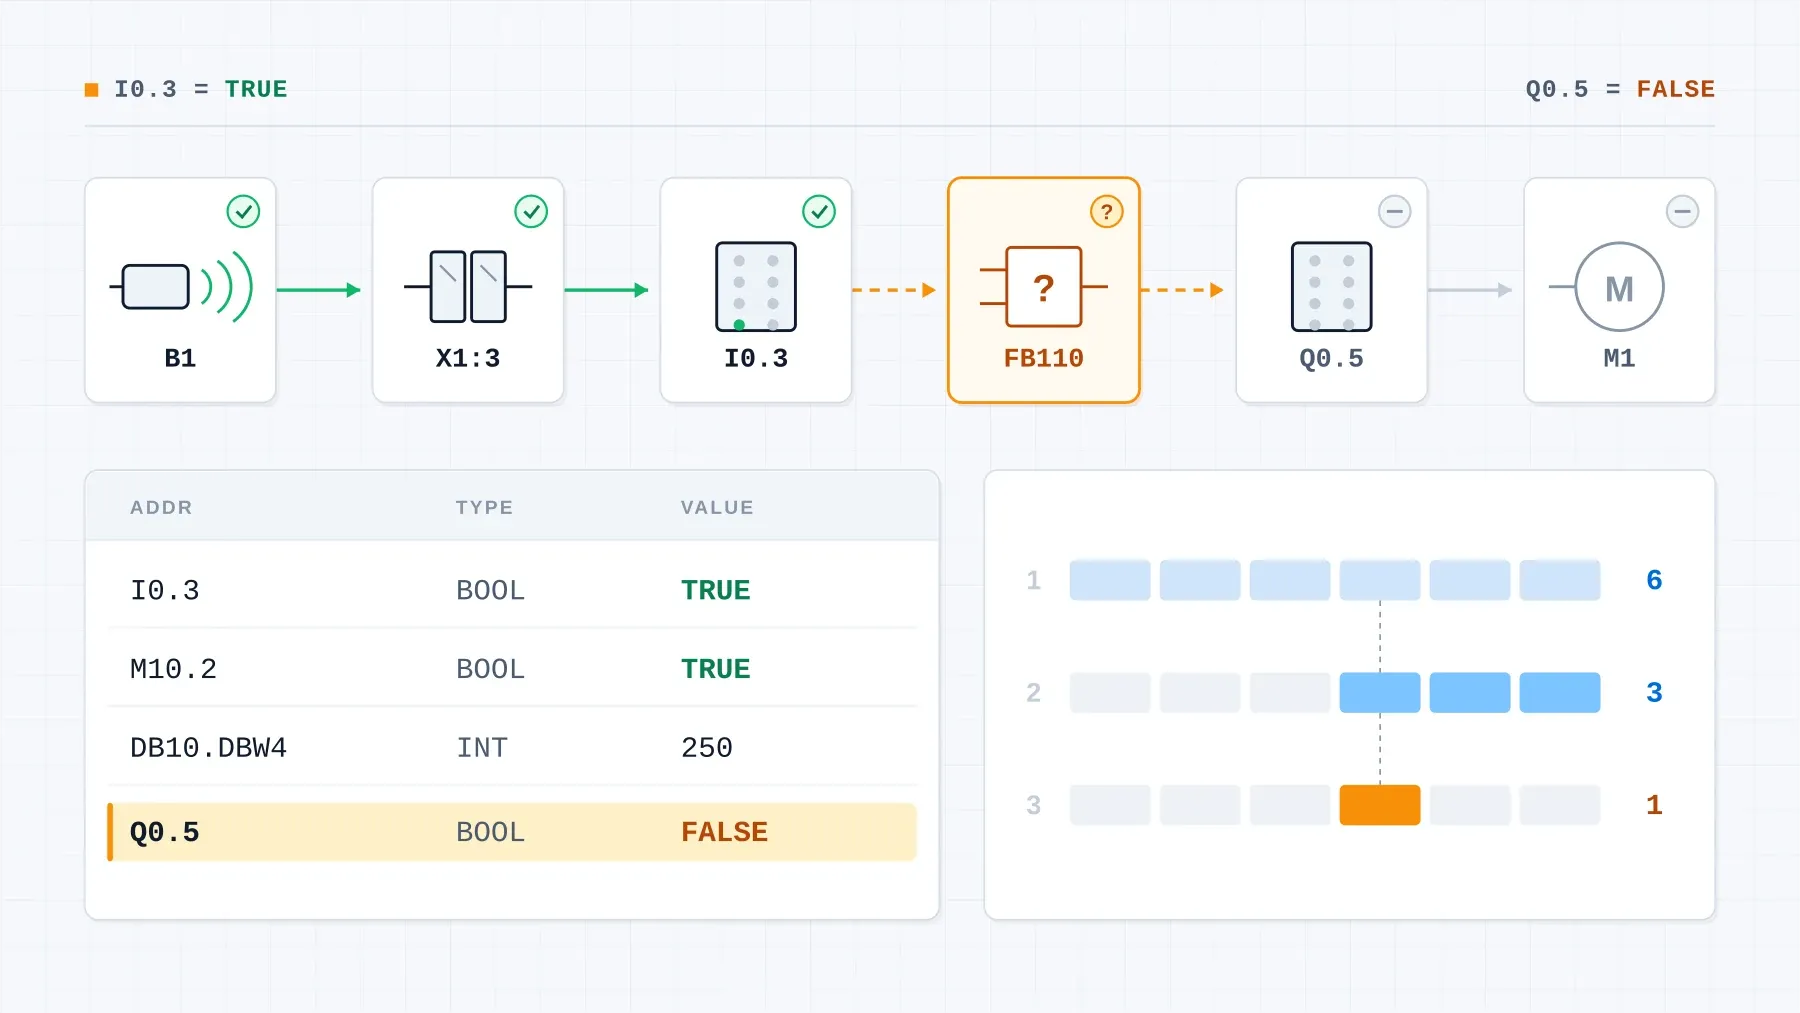
Nehmen Sie den Ausgang, der nicht schaltet, und arbeiten Sie sich zu seinen Bedingungen zurück. Welche Verknüpfung verhindert das Setzen? Welche dieser Teilbedingungen ist falsch? Und warum?
Dieses Rückwärtsgehen ist der Kern der Methode. Es endet immer an einem von drei Punkten: einer Eingangsbedingung, die nicht kommt (Hardware oder vorgelagerte Logik), einer Verriegelung, die greift (meist beabsichtigt), oder einer Zuweisung, die von woanders überschrieben wird.
Schritt 5: Was zu schnell ist für die Beobachtungstabelle – Trace
Manche Effekte sind im Zyklus nicht zu greifen: ein Signal, das 20 Millisekunden ansteht, eine Flanke, die im falschen Moment liegt, ein Timer, der nur sporadisch nicht abläuft. Dafür ist die Trace-Funktion da. Sie zeichnet ausgewählte Variablen zyklussynchron auf und zeigt den Verlauf statt des Momentwerts.
Der entscheidende Griff dabei: den Trigger auf die Meldung selbst setzen. Dann läuft die Aufzeichnung genau in dem Moment, in dem der Alarm kommt, und man sieht die Millisekunden davor – statt darauf zu warten, dass der Fehler passiert, während man zusieht. Aufgezeichnet wird alles, was an der Meldung beteiligt ist: die auslösenden Geber, die Verriegelungen, die Zeitglieder.
Die Werkzeuge: am Panel und im TIA Portal
| Werkzeug | Wofür es taugt | Typische Anwendung |
|---|---|---|
| Alarmdiagnose am HMI | Welche Meldung steht an, seit wann, in welcher Reihenfolge? | Der erste Blick. Die erste Meldung ist meist die Ursache, der Rest Folgemeldung |
| Beobachtungstabelle | Live-Werte mitlesen, ohne den Prozess zu stören | Das Standardwerkzeug im Code. Signale des verdächtigen Bausteins zusammenstellen und mitlaufen lassen |
| Querverweise | Wo wird eine Variable geschrieben, wo gelesen? | Vom Meldebit in den erzeugenden Baustein; erstes Mittel gegen Doppelzuweisungen |
| Trace | Signalverlauf zyklussynchron aufzeichnen, mit Trigger | Für alles, was zu schnell oder zu selten für die Beobachtungstabelle ist |
| Aufrufstruktur | Wird der Baustein überhaupt zyklisch aufgerufen? | Wenn ein Baustein „nichts tut“, obwohl die Logik stimmt |
| Diagnosepuffer | Hardware-Ereignisse mit Zeitstempel | Wenn am HMI keine Meldung ansteht oder es nach Baugruppe riecht |
| Online-/Offline-Vergleich | Weicht die CPU vom dokumentierten Stand ab? | Deckt undokumentierte Änderungen „von der letzten Nachtschicht“ auf |
| PLCSIM | Logik ohne Anlage nachstellen | Für reproduzierbare Fehler und zum gefahrlosen Durchspielen von Varianten |
Forcen: das Werkzeug, das man fast nie braucht
Forcen überschreibt physische Ein- und Ausgänge und bleibt aktiv, bis es explizit aufgehoben wird – auch über einen CPU-Neustart hinweg. An einer laufenden Anlage mit bewegten Achsen ist das ein Sicherheitsrisiko, kein Diagnosewerkzeug.
Zum reinen Beobachten genügt die Beobachtungstabelle. Wenn Sie tatsächlich einen Wert setzen müssen, tun Sie es gezielt, dokumentiert und mit einem Kollegen, der die Anlage im Blick hat – und heben Sie es auf, bevor Sie gehen. Ein vergessener Force ist eine Zeitbombe, die beim nächsten Anlauf hochgeht, wenn niemand mehr weiß, dass er gesetzt wurde.
Fünf Fehlerklassen, die den Großteil ausmachen
1. Doppelzuweisungen
Dieselbe Variable wird in zwei Bausteinen geschrieben. Im zyklischen Ablauf „gewinnt“ die zuletzt bearbeitete Zuweisung – der Ausgang flackert oder bleibt hartnäckig auf einem Wert, obwohl die sichtbare Logik etwas anderes sagt.
Erkennung: Querverweise. Jede Variable mit mehr als einer schreibenden Stelle ist verdächtig.
2. Flankenfehler
Eine Aktion feuert dauerhaft statt einmalig, oder gar nicht. Ursache ist meist eine fehlende steigende Flanke (R_TRIG) oder ein Flankenmerker, der an mehreren Stellen verwendet wird – dann verbraucht die erste Auswertung die Flanke, und die zweite sieht nie eine.
Erkennung: Beobachtungstabelle auf dem Flankenmerker plus Querverweise darauf.
3. Zeit- und Zyklusprobleme
Ein Timer, dessen Startbedingung im selben Zyklus zurückgesetzt wird, läuft nie ab. Umgekehrt lösen zu lange Zykluszeiten den Zeitfehler-OB (OB80) aus – sichtbar im Diagnosepuffer.
Erkennung: Zykluszeit in der CPU-Diagnose prüfen, Timer-Eingang in der Beobachtungstabelle mitlesen.
4. Datenbaustein-Verwechslung
Bei mehrfach instanziierten Funktionsbausteinen wird der falsche Instanz-DB übergeben. Die Logik stimmt, aber Antrieb 2 reagiert auf die Werte von Antrieb 1.
Erkennung: Aufrufstruktur ansehen – welcher Baustein bekommt welchen DB?
5. Hardware, die sich als Software tarnt
Ein wackelnder Initiator, ein Kabelbruch im Schleppketten-Bereich, eine Baugruppe mit sporadischem Ausfall. Das Symptom ist im Programm sichtbar, die Ursache nicht.
Erkennung: Sporadik ist das Warnsignal. Ein Fehler, der sich nicht reproduzieren lässt, liegt selten in der Logik – Logik ist deterministisch.
Wenn die Anlage steht: die Reihenfolge unter Druck
Wenn die Produktion wartet, hilft eine feste Reihenfolge mehr als Intuition:
- Meldefenster lesen. Welche Meldung steht an, seit wann, und welche kam zuerst?
- Steht keine Meldung an: Diagnosepuffer und LEDs. Klärt in Sekunden, ob überhaupt die Software gemeint ist.
- Symptom präzise formulieren. Was genau passiert nicht, seit wann, unter welchen Bedingungen?
- Letzte Änderung erfragen. „Lief gestern noch“ ist die wichtigste Information überhaupt – der Online-/Offline-Vergleich zeigt, ob jemand etwas angefasst hat.
- Vom Meldebit rückwärts über Querverweise in den Baustein, dann Beobachtungstabelle für den verdächtigen Bereich – statt sich durch Netzwerke zu klicken.
- Trace aufzeichnen, wenn der Effekt zu schnell oder zu selten für die Beobachtungstabelle ist.
- Befund dokumentieren, bevor Sie die Anlage wieder freigeben – sonst wiederholt sich alles beim nächsten Mal.
Punkt 7 wird unter Druck fast immer weggelassen und ist der einzige, der verhindert, dass dieselbe Suche in drei Monaten von vorn beginnt.
Sauberer Code ist Diagnose-Infrastruktur
Die meisten Punkte oben setzen etwas voraus: eine klare Bausteinstruktur, sprechende Namen, kommentierte Symbolik. Das ist kein Selbstzweck und keine Ästhetikfrage.
Ein Programm, in dem jeder Anlagenteil gekapselt und benannt ist, verwandelt stundenlanges Rätselraten in ein gezieltes Eingrenzen von Minuten. Ein kommentierter Baustein sagt Ihnen schon beim Draufschauen, was er tun soll – und damit auch, wo er vom Soll abweicht. Ein Baustein voller M0.0 und DB1.DBX0.0 sagt gar nichts, und die Fehlersuche beginnt bei null.
Fazit
Fehlersuche ist Methode, nicht Talent. Drei Dinge tragen den größten Teil:
- Erst das Meldefenster – die Anlage sagt meist selbst, was ihr fehlt; die erste Meldung ist die Ursache, alles danach Folgemeldung.
- Kein Alarm ist auch ein Befund – dann klären Diagnosepuffer und LEDs in Sekunden, ob die Software überhaupt gemeint ist; und danach steht die Frage im Raum, warum es für diesen Fall keine Meldung gibt.
- Rückwärts vom Symptom statt vorwärts von der Vermutung – jeder Schritt verkleinert den Suchraum, auch wenn die Annahme falsch war.
- Reproduzierbar oder sporadisch? – diese Unterscheidung trennt Software- von Hardware- und Timing-Problemen, bevor Sie das erste Netzwerk öffnen.
- Werkzeug nach Fehlerklasse – Logikprobleme über die Meldungen am HMI, Kommunikations- und Hardwarefehler über den Diagnosepuffer, sporadische Effekte über einen Trace mit Trigger auf die Meldung.
Weiterführende Artikel
- SPS-Programmierung: 8 Best Practices für sauberen, wartbaren Code – die Struktur, die Fehlersuche erst effizient macht
- SPS-Dokumentation: Was hineingehört, was bei der Übergabe zählt – warum die Alarmliste im Störfall entscheidet
- Die 5 SPS-Programmiersprachen nach IEC 61131-3 – welche Sprache sich wie gut debuggen lässt